|
📰 En esta edición
-
• SEMICONDUCTORES: Google presenta su cuarto chip de IA del año, con el doble de potencia en el mismo espacio
-
• INTELIGENCIA ARTIFICIAL: OpenAI regalará ChatGPT a 200,000 investigadores, pero con el plan más barato
-
• ESPACIO: Un cohete Vulcan falla a los 10 minutos y destruye 40 satélites de Amazon
-
• CIBERSEGURIDAD: Google detecta el primer ciberataque hecho de principio a fin por una IA
-
• COMPUTACIÓN CUÁNTICA: Nvidia reduce de 12 semanas a 45 minutos el diseño de computadoras cuánticas
Martes, 17 de noviembre de 2026 · 5 historias
|
💾 SEMICONDUCTORES
Google suma dos chips de IA: ya son cuatro en un año
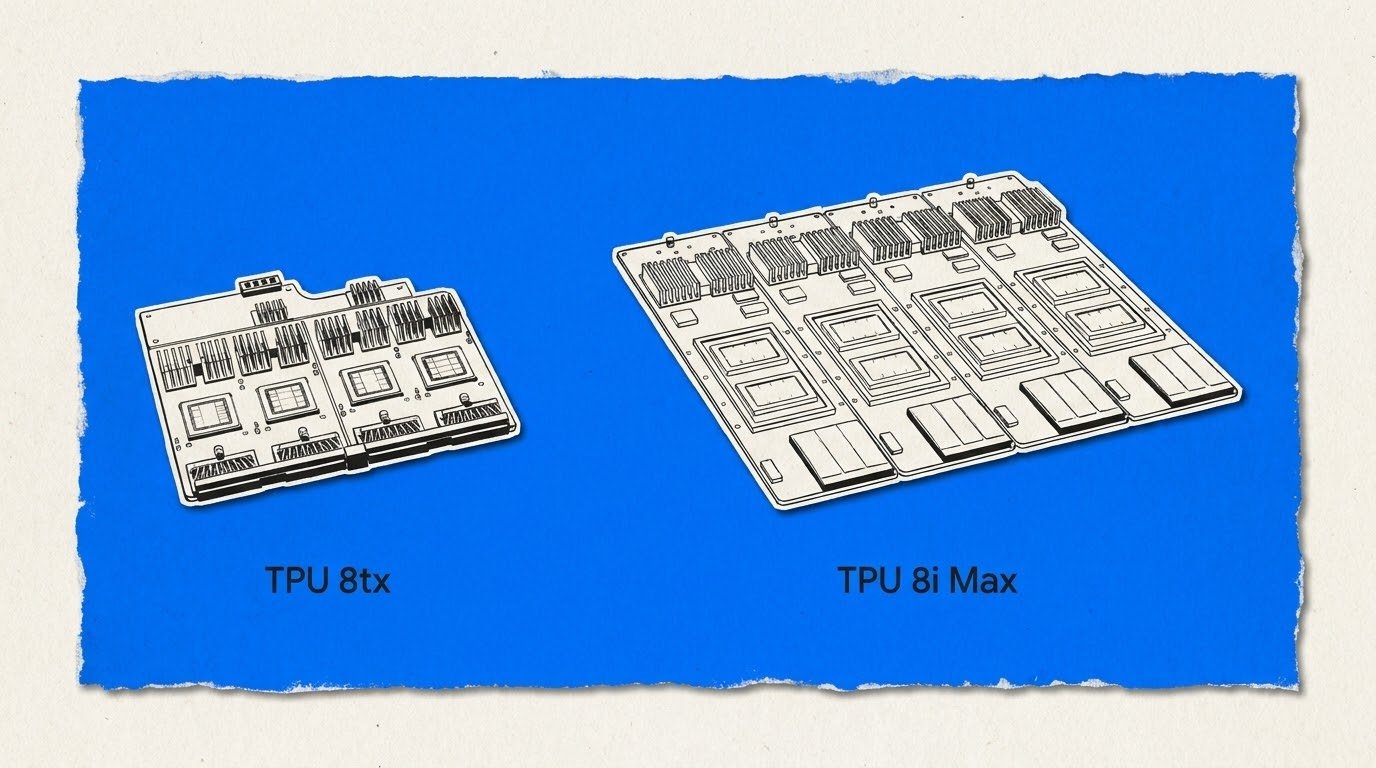
Google amplió su octava generación de chips de IA con dos sistemas nuevos: TPU 8tx y TPU 8i Max. Se suman a los TPU 8t (para entrenar modelos) y 8i (para respuestas en tiempo real) que presentó en abril, y es la primera vez que la empresa lanza cuatro sistemas TPU en un mismo año, según Amin Vahdat, su jefe de tecnología en IA e infraestructura. El 8tx usa el mismo silicio que el 8t, trabaja junto con procesadores AMD EPYC de quinta generación, tiene hasta 2 veces menos latencia (retraso) que el 8t y cifra los datos desde el propio hardware. El 8i Max une dos chips 8i en un solo paquete: el doble de cómputo, de memoria SRAM y de ancho de banda de memoria HBM, y mete el doble de silicio en el mismo espacio de rack. Además, un software llamado TPU Sync recorta en más de 90% el tiempo que tarda un modelo en dar la primera palabra de su respuesta. Google no dio precios ni fecha de disponibilidad.
El mensaje de fondo es que la carrera de la IA ya no es solo entrenar modelos gigantes, sino responder rápido y barato a millones de personas y agentes al mismo tiempo. Ahí apuntan estos chips: según Google, la generación actual ofrece hasta 2.7 veces más rendimiento para entrenar y 80% mejor relación precio-rendimiento para responder que la anterior. Las TPU ya no son solo para uso interno: además de mover a Gemini, atienden a casi 100 clientes, entre laboratorios de IA, firmas de trading, cadenas comerciales y universidades, y pueden instalarse en los centros de datos de los propios clientes. El cifrado por hardware del 8tx responde a una petición de sectores muy regulados, como el financiero. Hay un detalle curioso: Google dice que usó a Gemini para diseñar la distribución de sus chips en horas y no en semanas.
💡 Contexto clave
Una TPU es un chip que Google diseña solo para IA, a diferencia de las GPU de Nvidia, más versátiles y dominantes en el mercado. Tener chips propios le da a Google más control sobre costos y suministro; Amazon y Microsoft siguen la misma ruta con los suyos. La HBM es memoria ultrarrápida pegada al chip: suele ser el cuello de botella, porque de poco sirve calcular rápido si los datos llegan lento.
|
Fuente: Google →
⏱ ~85 segundos lectura
|
🤖 INTELIGENCIA ARTIFICIAL
OpenAI duplica su meta y regalará ChatGPT a 200,000 científicos, aunque con letra chiquita
OpenAI anunció este lunes que ampliará su programa ChatGPT for Academic Researchers para dar acceso gratuito a hasta 200,000 investigadores en el mundo, el doble de la meta con la que arrancó el piloto en julio. La siguiente ronda abre el lunes 23 de noviembre con 50,000 becas que se entregarán por orden de llegada a quienes cumplan los requisitos, y no por sorteo. Cada beca cubre al investigador y hasta dos colaboradores, así que esta ronda puede alcanzar a 150,000 personas. El cambio importante es el plan: los participantes del piloto recibieron ChatGPT Pro, y los nuevos tendrán ChatGPT Plus, más limitado; OpenAI asegura que la mayoría de los usuarios del piloto no habría rebasado los límites de Plus. Hasta ahora se han unido 20,000 investigadores en 33 países, y la empresa dice que, por defecto, no usa los datos del programa para entrenar sus modelos.
OpenAI acompañó el anuncio con un estudio de más de 1,800 científicos: leer y aprender ocupó 28% de sus mensajes sobre ciencia, y escribir, 27%. Los encuestados dijeron que sin IA el mismo trabajo les habría tomado casi el doble de tiempo, aunque la propia empresa aclara que es una percepción y no prueba que la IA acelere los descubrimientos. Detrás de la generosidad hay competencia: Anthropic lanzó Claude Science en junio y Google DeepMind abrió sus modelos científicos a 200 investigadores europeos en octubre. Quien acostumbre a un laboratorio a sus herramientas tiene ventaja para venderle a toda la universidad después. OpenAI no ha detallado qué países entran en esta ronda, así que los académicos de México y Latinoamérica tendrán que revisar los requisitos el día 23.
Fuente: OpenAI →
⏱ ~75 segundos lectura
|
🚀 ESPACIO
Falla el cohete Vulcan de ULA y Amazon pierde 40 satélites de su rival de Starlink
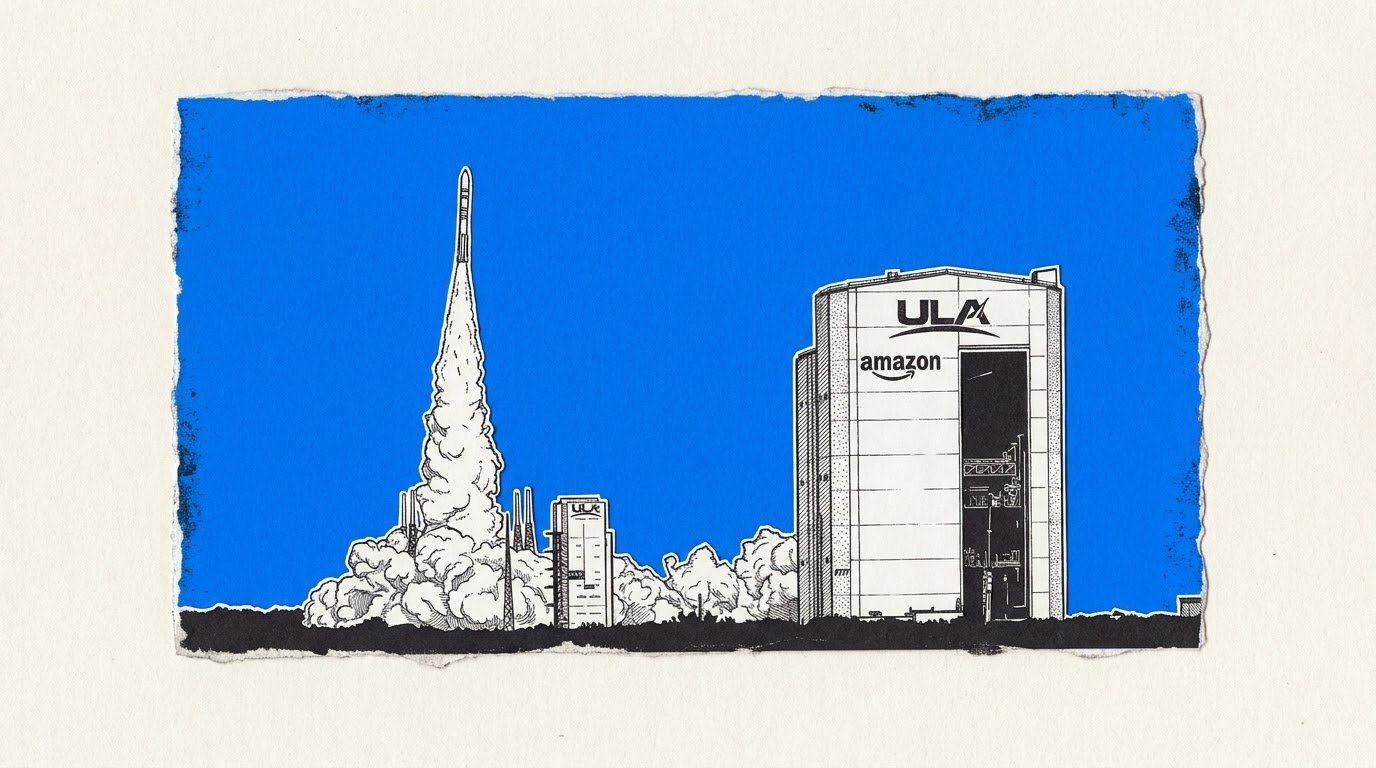
Un cohete Vulcan de United Launch Alliance (ULA), la empresa conjunta de Boeing y Lockheed Martin, despegó el domingo a las 11:40 de la mañana (hora de la Ciudad de México) desde Cabo Cañaveral, Florida, con 40 satélites de Amazon Leo, el servicio de internet satelital de Amazon. ULA informó que el vehículo sufrió una anomalía “10 minutos después del despegue” y no logró poner la carga en órbita, así que los satélites se perdieron. Los propulsores sólidos funcionaron con normalidad; el problema surgió durante el encendido de la etapa superior Centaur, aunque la causa exacta aún se desconoce. Es la primera falla total de ULA desde que se fundó en 2006. Era el quinto vuelo del Vulcan, el primero en nueve meses, y también el primero de los 38 lanzamientos que Amazon le compró a este cohete.
El golpe es doble para Amazon. Su red necesita más de 3,300 satélites, y con este vuelo habría llegado a 436 lanzados. Ahora tendrá que esperar la investigación antes de volver a usar el Vulcan, y su otro gran aliado, el New Glenn de Blue Origin, también está en tierra desde que explotó en su plataforma en mayo. Le quedan reservas con Ariane 6 (24 vuelos) y con el Falcon 9 de SpaceX (13 vuelos), es decir, con la empresa de su principal competidor, Starlink. Para ULA el problema es igual de serio: el Vulcan es el reemplazo de su veterano Atlas 5, y la Fuerza Espacial de EU ya había pausado sus lanzamientos militares en este cohete por fallas previas en los propulsores. El administrador de la NASA, Jared Isaacman, ofreció ayuda y escribió que Artemis y la nación “necesitan a ULA”.
💡 Contexto clave
Amazon Leo, antes llamado Project Kuiper, pone satélites en órbita baja, a unos cientos de kilómetros de altura, para dar internet con poco retraso, igual que Starlink. Como cada satélite cubre una zona pequeña, se necesitan miles. La etapa superior es la parte del cohete que da el empujón final para alcanzar la órbita: si falla, la carga cae o se queda en una trayectoria inútil.
|
Fuente: Spaceflight Now →
⏱ ~85 segundos lectura
|
🔐 CIBERSEGURIDAD
Google descubre el primer ciberataque hecho de principio a fin por una IA, sin humanos de por medio
El Grupo de Inteligencia de Amenazas de Google (GTIG) y su filial Mandiant informaron este lunes que hackers de habla rusa realizaron lo que consideran el primer ciberataque operado de principio a fin por inteligencia artificial, sin intervención humana en ninguna etapa. En un servidor que los atacantes dejaron expuesto, los investigadores encontraron un sistema que bautizaron exploit_agent: coordina varios agentes de IA, con modelos comerciales y otros instalados en computadoras propias (Google no dijo cuáles). Su método es revisar sin parar el código de programas muy usados antes y después de que salga una actualización de seguridad. Cuando aparece un parche, deduce qué falla corrige, escribe un ataque para aprovecharla y lo lanza solo. Las víctimas fueron sitios web franceses de medios, entretenimiento y educación. Google no señaló a ningún grupo ni gobierno; la pista rusa sale de comentarios en ese idioma dentro del código.
Google lo llama un “punto de inflexión crítico”: hasta ahora veía que los atacantes usaban la IA para ir más rápido en tareas dirigidas por personas, como redactar correos falsos o escribir código, no para operar solos. La velocidad ya se nota en los números: tras un parche a dos fallas del lenguaje web PHP el 21 de octubre, en días aparecieron cientos de supuestos ataques, casi todos inservibles y probablemente generados por IA. Además, Google contó 22 vulnerabilidades de día cero explotadas solo en agosto, contra 11 al mes a inicios de 2026 y 8 al mes en promedio en 2025. Para empresas y usuarios, la lección es concreta: el tiempo entre que sale una actualización y llega el ataque se acorta, así que posponer el “actualizar después” sale cada vez más caro.
Fuente: CyberScoop →
⏱ ~75 segundos lectura
|
⚛️ COMPUTACIÓN CUÁNTICA
Nvidia corrige errores cuánticos hasta 13,000 veces más rápido y se alía con IBM y Fermilab
Nvidia presentó TCBP-JOBS, un algoritmo para la corrección de errores en computadoras cuánticas que ya está disponible en su biblioteca de software CUDA-Q QEC. Según la empresa, encuentra los errores hasta 13,000 veces más rápido que los mejores algoritmos actuales sin perder precisión, y reduce de 12 semanas a 45 minutos el cálculo necesario para estudiar nuevos diseños de computadoras cuánticas. Para probarlo se asoció con IBM y con el Fermilab, laboratorio del Departamento de Energía de EU, en una plataforma que coloca supercomputadoras Nvidia DGX B200 junto a computadoras cuánticas de IBM, incluidas las que usan su procesador Nighthawk. En paralelo, IBM, el instituto japonés RIKEN y Nvidia simularon un cúmulo de hierro y azufre presente en proteínas: lograron una precisión 79 veces mayor que en intentos previos del mismo experimento, con hasta 72 qubits y 4,000 operaciones entre pares de qubits.
Conviene no confundirse: esto no significa que ya existan computadoras cuánticas libres de errores. Es una herramienta para investigar más rápido, porque permite probar muchas combinaciones de códigos de corrección en minutos y elegir los diseños que aprovechan mejor cada qubit, el recurso más caro y escaso. También muestra la estrategia de Nvidia: en lugar de fabricar su propia computadora cuántica, quiere que sus chips sean el socio indispensable de cualquiera que la construya. En la misma línea, está adaptando Slurm, un software muy usado para repartir tareas en supercomputadoras, para que los investigadores agenden un procesador cuántico como si fuera un recurso más del centro de datos.
💡 Contexto clave
Los qubits son tan frágiles que una vibración o un cambio mínimo de temperatura altera sus cálculos. La solución es agrupar muchos qubits físicos para formar un qubit lógico confiable. El decodificador es un programa en una computadora normal que lee las mediciones, adivina dónde hubo errores y ordena corregirlos. Tiene que ser muy rápido, porque los errores aparecen todo el tiempo. IBM, Google y Quantinuum compiten por llegar primero a máquinas tolerantes a fallas.
|
Fuente: Interesting Engineering →
⏱ ~85 segundos lectura
|
|
